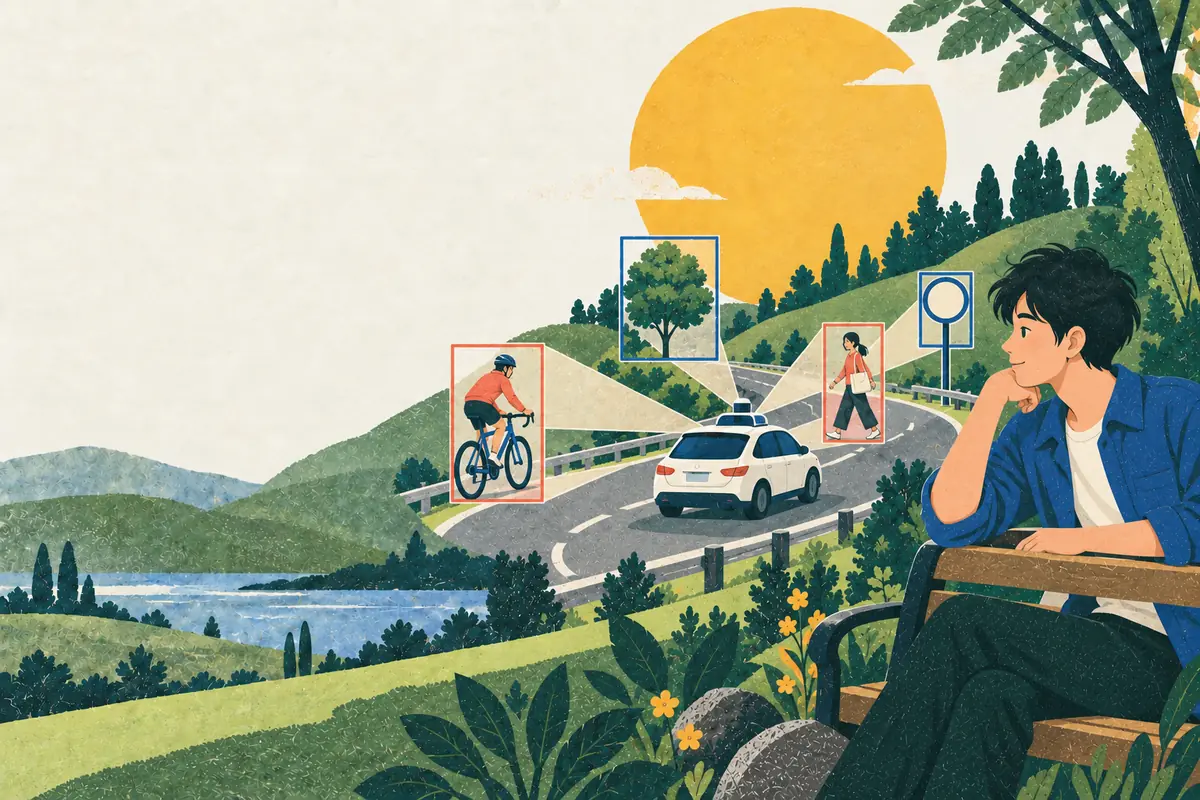
把传感器信号变成可供驾驶使用的世界状态——包括诚实地标出哪里没看到。
先看一次差点出事的两帧
回到那个路口。车停在支路的停止线前,等着右转汇入主路。上一章已经把目标车道交代清楚,也知道入口被施工锥桶挤窄了半个车道。现在要回答下一个问题:主路上到底有什么?
主路上,一辆深色轿车正从相邻车道往你要汇入的那条车道切过来(这个动作叫 cut-in,横向切入)。横向速度不大,但意图明显。就在这时,一辆公交车从它外侧开过,把它整个挡住了。整整两帧,相机里没有这辆轿车。
如果感知是“一帧一算”的,每帧独立跑一次检测、输出一堆检测框,事情会这样发展:
- 这两帧里,深色轿车从输出里消失了;
- 下游拿到的场景是“目标车道空闲”,决策层据此判断可以起步汇入;
- 第三帧公交车开过去,轿车重新出现,已经比两帧前更深地插进了目标车道。
这就是本章要解决的问题。感知不是“识别出更多目标”,而是回答三个层层递进的问题:
- 看到了什么:车、人、灯、车道线、锥桶各在哪里;
- 它们和几帧之前是什么关系:那辆轿车还是那辆轿车吗,它的速度连续吗;
- 哪里没看到:公交车后面不是“空”,是“看不见”。
第三个问题最容易被忽略,也最致命。读完整章你会发现,感知技术这些年的演进,很大程度上就是把这三个问题一个一个补齐。
量产感知系统的四块拼图
先把结构摊开。按任务数,感知有六项:2D/3D 检测、跟踪、车道线与路沿、红绿灯、道路标识、Occupancy。但量产系统不按六个任务组织,常见的是三块:动态、静态、红绿灯,Occupancy 挂在动态那一路上。为了讲清楚,这里把 Occupancy 单列,按四块讲:
| 模块 | 负责什么 | 在我们的路口 |
|---|---|---|
| 动态检测 | 车、人、骑行者的 3D 检测和跟踪:位置、尺寸、朝向、速度、身份 | 主路车流、正在切入的深色轿车 |
| 静态感知 | 车道线、路沿、停止线、人行横道、道路标识,实时恢复局部道路结构 | 被锥桶改过的入口边界 |
| Occupancy | 空间占用:逐格回答“被占了没有”,不要求先认出类别、框成规则形状 | 锥桶本身,以及公交车后面那块看不见的区域 |
| 红绿灯 | 信号灯的三维位置、颜色和类型 | 右转信号灯 |
量产常用的“感知 one-model”共用一个图像骨干,再分出动态、静态两路 BEV 特征:动态那一路接检测头和 Occupancy 头,静态那一路接车道线头和标识、停止线头。红绿灯的做法最能说明量产的讲究:它通常另配两个模型。
- 检测用 Sparse4D 这类 3D 检测模型:要知道那盏灯的三维位置,才能回答“这盏灯管不管我这条道”;
- 识别用 ShuffleNet 这类很轻的分类模型:判断颜色和箭头类型这类语义,用不着重型网络。
记住这个手感:感知通常是一个骨干、多个专门的头,红绿灯另配两个小模型;各块有各块的解法,再共享底层表征。下面几节沿这几块展开:先讲共享表征怎么来(BEV),再讲别的传感器怎么接进来、动态目标怎么跟踪;然后是静态感知和 Occupancy。红绿灯上面已经说完了。
从像素到俯视图:BEV 解决的是“平面不对”的问题
相机给的是图像平面,横竖都是像素。但驾驶需要的判断,比如距离多少米、在哪条车道、轨迹会不会冲突,都发生在俯视平面上。传统视觉任务是“图像进、图像出”,分割和检测都是这样;自动驾驶感知要的是“图像进、俯视平面出”。这一步平面转换,就是 BEV(鸟瞰图)表征的核心含义;六路相机也在这一步被统一到同一张图里。
难点在于相机没有深度。一个像素属于 10 米外的轿车,还是 40 米外的货车,图像本身不告诉你。2020 年的 LSS 给了一个此后被反复沿用的思路:深度不确定,就不猜一个值,而是给每个像素估一个深度分布。
- 每个像素来自六路相机
- Lift候选点沿视线排开一串,带深度概率
- Splat俯视栅格按相机内外参投上去
- 鸟瞰图车、车道、轨迹同一坐标系
这条路跑通之后,改进很快跟上。CaDDN 发现 LSS 的深度没有监督、不稳定:可视化出来,特征在俯视图上呈放射状弥散;给深度加上监督,特征就在物体的真实位置聚成亮块。一组“弥散还是聚焦”的对比图,就说清了深度有没有监督的差别。
顺便记一组数字,它是“感知范围”的具体形态:BEVDet 的 BEV 特征图是 128×128 的栅格,覆盖自车前后左右各 51.2 米,每格 0.8×0.8 米。有人问“这套感知方案范围多大、分辨率多少”,答案就长这样。
到 2022 年,BEVFormer 换了个方向做同一件事:不再从图像把特征“推”到俯视图,而是在俯视图上铺一层可学习的 query,让每个 query 主动去图像上采样自己需要的特征,还把上一帧的 BEV 特征融合进来,让时序成为表征的一部分。代价也很实在:它在俯视图上铺了一大片 query,每个都要去图像里采样,在 V100 上只能跑约 2 帧每秒,拿服务器显卡跑都离上车差得远。同样建整张图的 BEVDet 走 LSS 路线,在 RTX 3090 上就能实时。精度和算力的这对矛盾贯穿感知技术史,第 7 章讲端到端架构取舍时还会遇到。
和 BEVFormer 同一时期,还有一条不建整张图的路线:Sparse。两条路线对照着看:
Dense
先建整张鸟瞰特征图
- 代表:LSS、CaDDN、BEVDet、BEVFormer
- 一张图通用,下游各种任务都能从上面取
- 速度看实现:query 式的 BEVFormer 约 2 帧每秒,LSS 式的 BEVDet 能实时;感知范围受栅格大小限制
Sparse
不建整张图,少量 query 直接取特征
- 代表:PETR、StreamPETR
- PETR 把三维位置编码进图像特征,检测 query 直接在图像特征上工作
- StreamPETR 帧间只传对象:每帧置信度最高的一批(比如 256 个)进记忆队列
- 代价:每种任务要单独配一套 query
不止相机:融合之前先对齐
上面讲的都是相机。很多车还装着激光雷达、毫米波雷达这类测距传感器。三者各有长短:
相机
认得出是什么
- 边缘、颜色、明暗都测得准,认类别、认灯色靠它
- 难在三维定位:图像不直接给深度
激光雷达
量得准在哪
- 三维定位精确
- 语义信息少,点云稀疏
毫米波雷达
测得出多快
- 看得远,靠多普勒效应直接测出径向速度
- 回波比激光雷达还稀,定位不准
BEV 正好是多传感器融合的公共画布。BEVFusion 用 LSS 把相机特征转到 BEV,和激光雷达的 BEV 特征拼在一起,再编码一次,检测和分割共用。融合后,小目标和夜间场景的效果都不错;我们路口的锥桶就是小目标,傍晚的光线也正在变暗。
融合有个前提:各路数据要对齐到同一个坐标系、同一个时刻。前者靠标定内外参,后者靠时间同步。BEVFusion 拼接两路 BEV 时要处理的不对齐,误差源就包括标定和时钟同步。
只用相机也躲不开对齐。PETRv2 实测过三类退化对 mAP 的影响:
- 外参误差:外参角度最多偏 6 度,掉 3.4 个点;
- 成像延迟:晚一帧(12 Hz 下约 0.083 秒)掉 3.2 个点,晚三帧掉 9.2 个点;
- 相机丢失:丢后视相机最伤,从约 40 掉到约 27。
架构也影响稳不稳:BEVFormer 对外参误差就比 LSS 稳。
跟踪:那辆车还是那辆车吗
检测是单帧的:每帧给出位置、尺寸、朝向。跟踪是时序的:给每个目标一个身份(ID),再估出速度和 yaw rate。经典做法是在检测后面接一道工序:
- 单帧检测位置、尺寸、朝向
- 跨帧关联新检测配已有轨迹:二分图匹配,常用匈牙利算法
- 跨帧滤波更新卡尔曼滤波用新观测修正轨迹状态
- 输出ID、速度、yaw rate
难点也藏在这条流程里:ID 跳变、速度误差大。遮挡时最容易出事:被挡住的轨迹只能靠运动模型往前推;推偏了,或者挡得太久,车再出现时就配不回原来的轨迹。ID 一跳,下游看到的就是一辆“新车”。
MOTR 换了个思路:在 DETR 的检测 query 之外,再加一组 track query。同一个 track query 跨帧传下去,它本身就代表这辆车,数据关联和 NMS 这类后处理都省了。Sparse4D v3 也有这种跟踪能力。前面的 StreamPETR 不一样:记忆队列传位置和速度,但不存 ID。
现在回头看开场那两帧。深色轿车被公交车挡住时,单帧检测器确实看不到它。但在带跟踪能力的 query 方案里,代表它的那个 query 还在。遮挡结束后,还是那个 query 把它接上:ID 不变,横向速度曲线连续。下游看到的不是“一辆车消失、又出现了一辆新车”,而是“那辆车切过来了,而且切得更深了”。跟踪的价值不在正常帧,而在丢失的那几帧。
跟踪交出的速度和 yaw rate,正是下一章物理外推的输入。评测上,检测常看 nuScenes 的 mAP 和 NDS,NDS 一半看 mAP,另一半看位置、尺寸、朝向、速度、属性五项误差;跟踪常看 AMOTA,即在不同召回率上取平均的 MOTA。
道路结构:地图给的和现场看的
感知的第二条战线是静态的:车道线、路沿、停止线、人行横道。这些信息有两个来源,而且正在此消彼长。
第一个来源是高精地图(HDMap),提前采集、离线制作。它的要求有多高:
- 建图误差不超过 ±30 厘米(这是另一份资料给的上限,没说是绝对还是相对误差;和上一章分级表的 50 厘米同属几十厘米量级);
- 制图自动化率要到 95% 以上,剩下 5% 靠人工修。
高速和高架还好,要覆盖城区,就得持续采集、制作、更新。总结成一句话:成本高、鲜度低、范围不足。上一章那排施工锥桶,就是鲜度问题的具象:地图说入口在这里,现场昨天挪了。
第二个来源是在线感知:车开到哪儿,就把局部道路结构实时“画”出来。这条路线演进很快:
- 2021HDMapNet用分割的思路画
- 2022VectorMapNet直接输出矢量点集
- 2022MapTR端到端输出,方向等价
- 2023StreamMapNet加上时序
MapTR 解决的一个问题,特别能说明工程里的真问题长什么样:一条车道线,从左往右描点和从右往左描点,是同一条线,但对网络来说是两个不同的答案。强制规定顺序,网络就得浪费容量去学一个不存在的“正确方向”。MapTR 让所有等价的描点顺序都算对:正序、逆序、闭合多边形的任意起点,全部接受。歧义消除了,训练就顺了。
线画出来还不够。规划器要的是车道之间怎么连:支路这条车道,接得进主路的哪几条。所以在线建图也在补拓扑:MapTR v2 把车道中心线加进了输出;也有方案用自回归解码器直接输出车道实例和一张邻接矩阵,写明哪条车道接哪条。无图时,上一章说的拓扑关系,靠的就是这一步。
于是现在的分工是:
- 导航地图指方向:从 A 到 B 的路网拓扑,成本低;
- 在线感知画细节:实时的局部车道结构,跟着现场走;代价是感知范围和精度都不如高精地图。
我们的系统就是这样处理锥桶的:地图先验说入口在原位,在线建图看到边界往左挪了半个车道,以现场为准,把修正后的入口交给下游。
检测框装不下的世界:Occupancy
检测框有一个隐藏前提:它只认识类别表里有的东西。车、人、骑行者、锥桶这些常见类别没问题。但路上还有清扫机器人、横穿的狗群、掉落的沙发、形状奇怪的养护车。它们出现得少、没有固定形状,类别表永远列不全。这类目标统称通用障碍物;检测它们的任务,简称 GOD(General Obstacle Detection)。很长一段时间里,通用障碍物只能靠激光雷达做几何聚类,噪声很大。
Tesla 把这个问题重新定义成一个可学习的任务,就是 Occupancy(占据栅格):把车周的空间切成三维小格子(voxel),不再要求先认出类别、框成规则形状,而是逐格回答“这块空间被占了没有”。
围绕一个格子,其实有三个问题,常被混成一个:
- 占没占:最基本的占据只回答这个。掉落的沙发认不出是什么,照样算“占了”。
- 是什么:语义占据再给每个被占的格子一个类别。类别表外的东西,Occ3D 标成“占了、类别未知”,单列为通用物体一类。评测也分开:IoU 只看占没占,mIoU 按类别算。
- 看没看到:Occ3D 的标注给每个格子三选一的状态,occupied 有东西,free 确认是空的,unobserved 没看到。
“类别未知”是认不出,unobserved 是没看到,两回事。公交车后面那块,不是认不出,是根本没看到。
unobserved 让训练和评测不把“没看到”算成“空闲”。但要注意,它是标注里的状态:到了车上,模型只输出占没占、是什么,不会告诉你哪里没看到。要让决策层知道公交车后面是盲区,系统还得在运行时另算一层可见性:沿着各个传感器的视线,判断哪些格子被挡住了,和占据结果一起交出去。我们的系统就是这么做的。
这就回答了开场的问题。公交车后面那块区域,在单帧检测的世界观里是“没有检测框,所以空闲”;加上可见性之后,它是“被挡住了,不许当作空闲”。决策层拿到的信息,从“可以走”变成了“那里是盲区”。这一字之差,可能就是“过早起步”和“再等一等”的差别。
这个任务的成本也值得记一笔。给 nuScenes 的 850 个场景补一套 Occupancy 标注,先用算法自动生成伪标签,再人工修正,一共花了约 4000 人工时,成本 10 到 15 万元,而这只是一个学术数据集的量级。纯人工标三维栅格不现实,主流以自动生成为主:这一套是自动生成再人工修正,也有 SurroundOcc 这样完全自动生成的。
另一个容易踩的坑是可见性:同一个格子,可能激光雷达看得见、相机看不见,反过来也一样。标注和评测时要分开定义两套可见性,否则你会惩罚模型“没预测出它根本不可能看到的东西”。
感知最终交付什么
把几条线收拢。这一章开始时,系统只有定位、地图和导航给的先验;现在,感知交给下游的是一份结构化的场景状态:
- 主路车流和深色轿车的检测框、身份和速度,包括被遮挡两帧后依然连续的那条横向速度曲线;
- 信号灯的位置、颜色和类型;
- 被锥桶修正过的入口边界、车道结构和车道连接;
- 一张 Occupancy 栅格和它的可见性:公交车后方的区域被如实标成“看不见”;
- 以及以上所有输出的置信度。
在端到端架构里,感知还会直接交出 BEV 或图像特征,以及检测、地图的 query,第 7 章再讲。
还有一项要单独说。量产的动态目标字段里,常见 predict_traj 和 predict_score:感知的动态头常常顺手给出每个目标未来几秒的轨迹和分数。所以第 3、4 章的分界不在模块名上,而在问题上:这一章回答“现在是什么”,下一章回答“接下来会怎样”,包括这版预测该怎么算、能信几分。
注意,这份交付物里没有“可以汇入”或“不能汇入”,那不是感知的职责。感知的职责是把世界状态说清楚,包括说清楚哪里没看清。把“没检测到”当成“不存在”的系统,和把“看不见”算出来、交出去的系统,用的可能是同一批模型;差别在于有没有给“不知道”留位置。
“世界现在什么样”说清楚了,接下来的问题更难:那辆切进来的轿车,下一秒会继续切,还是缩回去?主路后车会让,还是不让?场景状态是预测的输入,不是决策的答案。下一章,把当前场景延伸成几个可能的未来。
本章速查
| 概念 | 一句话 |
|---|---|
| 感知分块 | 量产常见三块:动态(检测 + 跟踪,Occupancy 头挂在这一路)、静态(车道线、路沿、标识)、红绿灯(检测 + 识别两个模型) |
| BEV | 把多相机特征投到以自车为中心的俯视栅格,让检测、地图、规划在同一平面坐标系里工作 |
| LSS | 给每个像素估深度分布(Lift),按内外参拍到 BEV 栅格(Splat);深度不确定就保留分布 |
| Dense vs Sparse | 建不建整张 BEV 特征图;Dense 的速度看实现(BEVFormer 约 2 帧每秒,BEVDet 能实时),Sparse 的 StreamPETR 兼顾精度和实时 |
| 对象级时序 | 只传播置信度最高的一批对象,而不是整张特征图;StreamPETR 的记忆队列不存 ID |
| 多传感器 | 相机认类别,激光雷达定位准,毫米波直接测径向速度;BEVFusion 在 BEV 上拼接相机和激光雷达特征 |
| 对齐与退化 | 融合先要标定和时间同步;PETRv2 实测晚三帧 mAP 掉 9.2 个点,丢后视相机最伤;BEVFormer 对外参误差比 LSS 稳 |
| 跟踪 | 经典流程:检测 → 二分图关联 → 卡尔曼更新,输出 ID、速度、yaw rate;MOTR 用 track query 省掉关联和 NMS |
| 评测指标 | 检测看 mAP、NDS,跟踪看 AMOTA |
| HDMap 成本账 | 误差 ≤ ±30 cm、自动化率 ≥ 95%;成本高、鲜度低、范围不足 |
| 在线建图 | HDMapNet → VectorMapNet → MapTR → StreamMapNet;MapTR 让点集的所有等价顺序都算对 |
| 车道拓扑 | 规划要的是车道之间怎么连:车道中心线、车道邻接矩阵 |
| Occupancy 分层 | 最基本的只答占没占;语义占据再给每格一个类别,类别表外的记成“类别未知” |
| Occupancy 三态 | 标注里分 occupied / free / unobserved;unobserved 是“没看到”,不是“认不出”;车上要另算可见性,才能把盲区交给下游 |
| 标注成本 | nuScenes 补 Occupancy 标注约 4000 人工时、10–15 万元,自动生成加人工修正;也有全自动生成的做法 |
| 感知里的预测 | 动态目标常带 predict_traj / predict_score;怎么算、能信几分,归下一章 |